內容共享
從 H100 伺服器到 RTX 5090 筆電:125B 大模型的地端部署革命
兩年前,想在公司跑一個 125B 等級的大模型,第一件事是簽一張六位數美金的預算;今天,同一件事的門檻變成「你家那台電競筆電夠不夠力」。這不是硬體降價,而是演算法把牆搬走了。
這篇文章記錄我手上這台 RTX 5090 Laptop,如何透過 Strata 引擎把 qwen-3-125b-moe-iq3_s 跑到接近即時的體驗,以及這件事在兩年前為什麼根本不可能。同時也把論述的邊界講清楚——哪些是這台機器真的做到的,哪些是條件式成立,我不想把特例講成通則。
本文重點
- 125B 未量化需要 250GB 權重+超長 KV Cache,整體衝到 300~400GB,單張 H100 根本塞不下,所以過去只能上 4×H100 的伺服器。
- MoE 稀疏化、IQ3 極致量化、分層異構快取——這三條曲線同時成熟,才讓 24GB VRAM 變成可能。
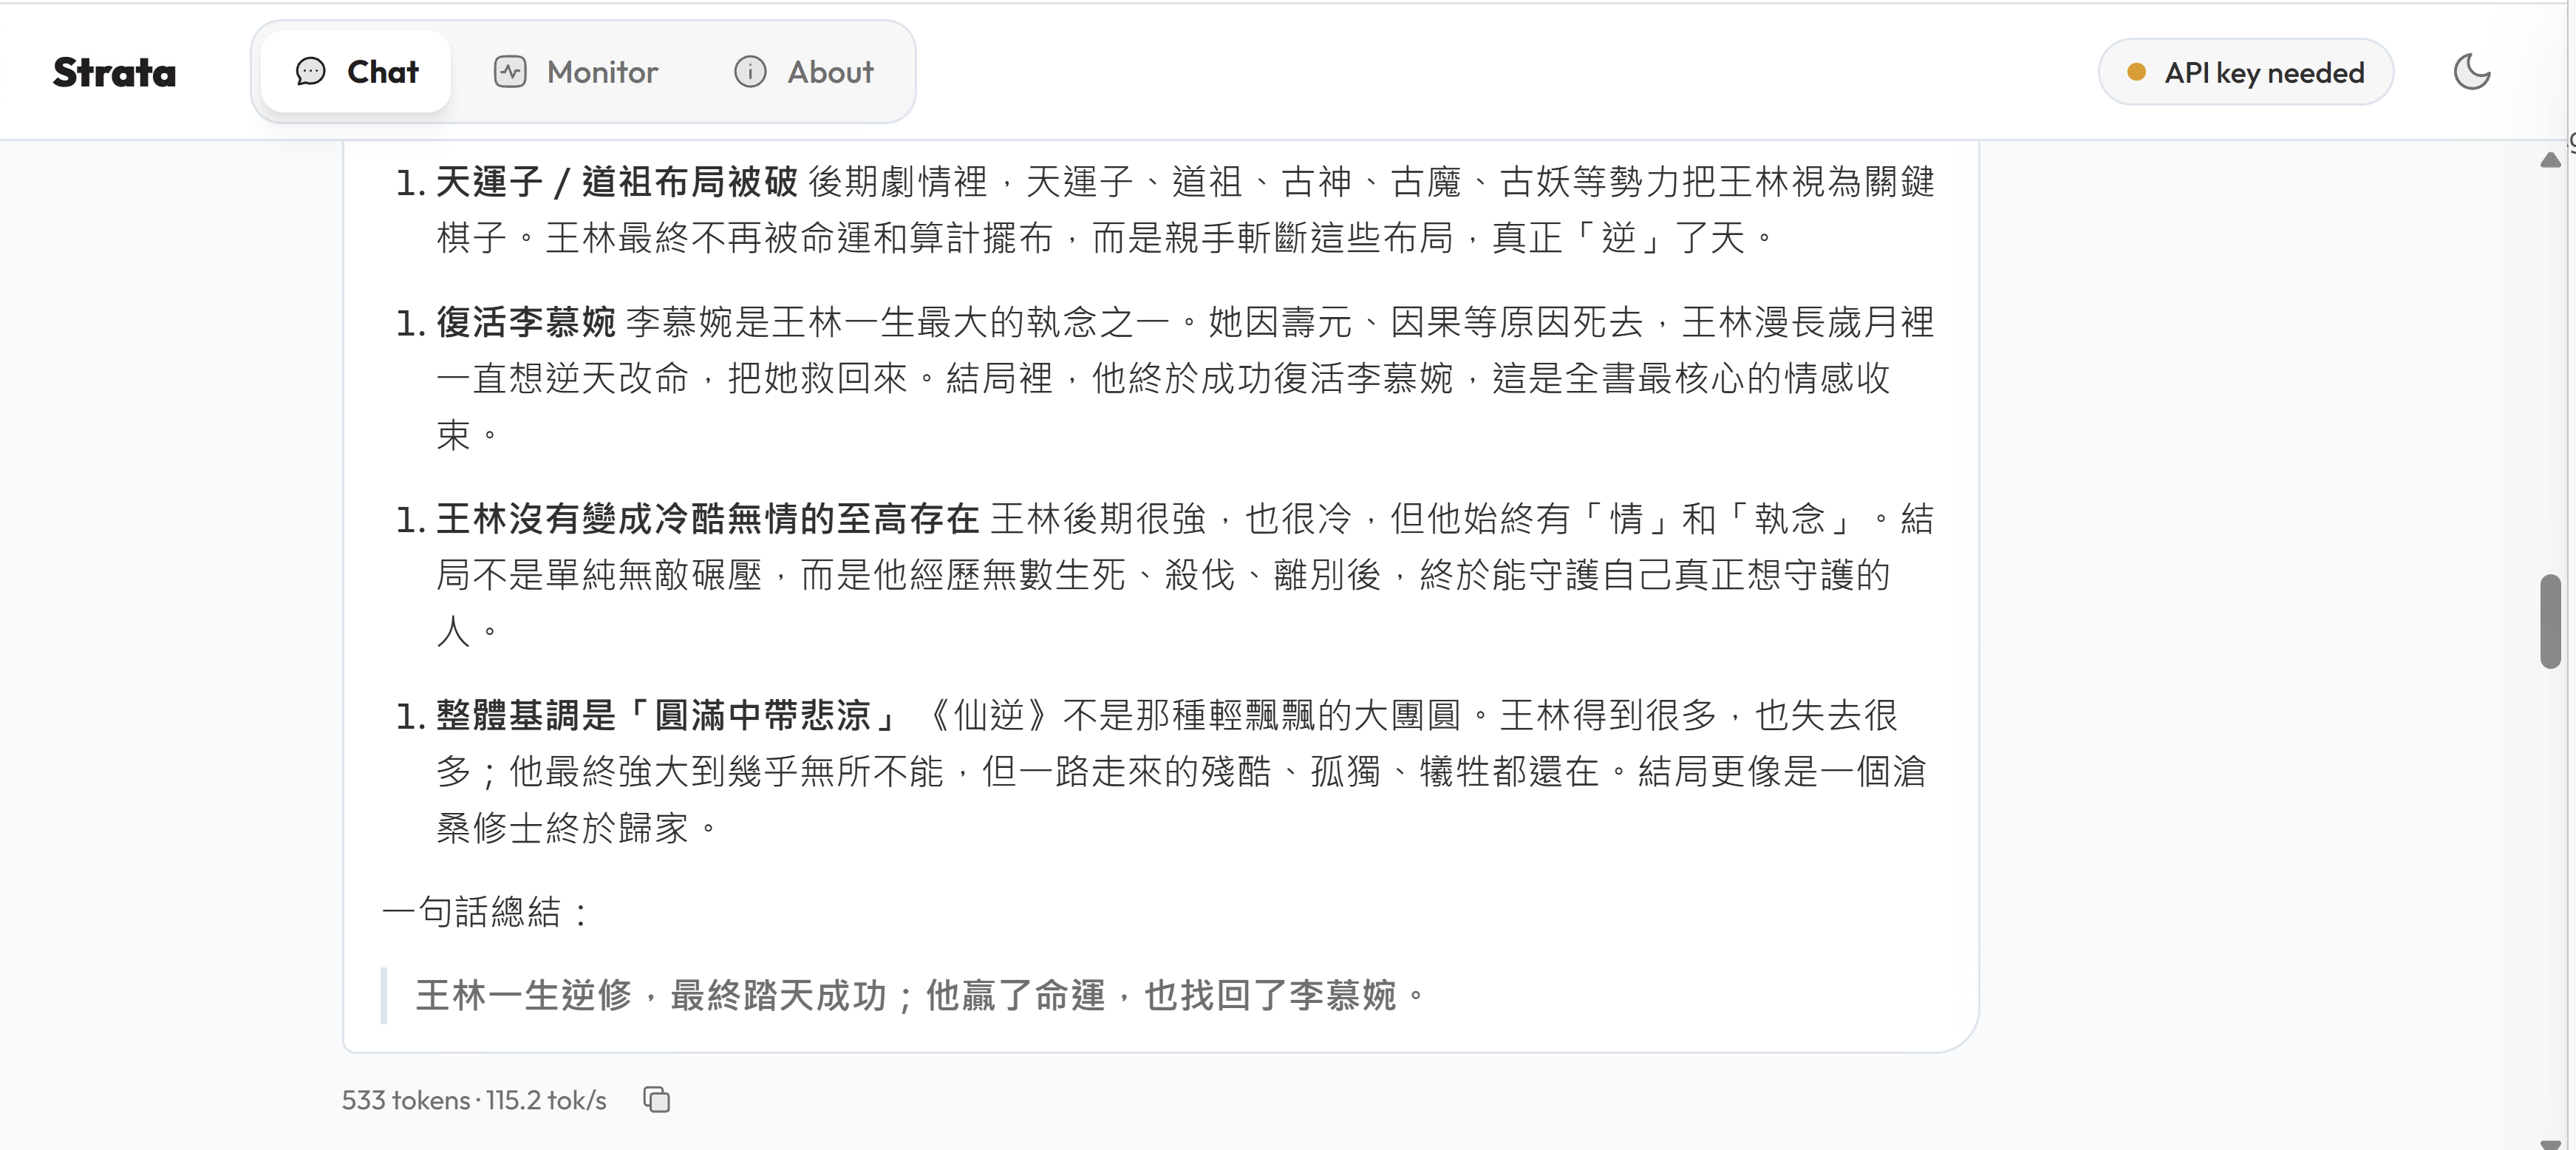
- 實測:OCR 零錯誤、98.8 tokens/s;帳簿抓碼測試 0.6 秒思考、84.7 tokens/s。
- 散熱不是瓶頸:175W 滿血功耗下,長時間推理穩壓在 75°C 以下(idle 38°C)。
- 一個被多數比較忽略的維度:私有資料不必交給雲端模型。地端模型接 MCP,筆記、文件、截圖都能直接讀取與分析,內容不會經過任何模型供應商。
- 三條邊界要說明:IQ3_S 的品質取捨、單用戶情境與企業級吞吐是兩回事、以及這是 Qwen MoE + Strata 的特化綜效而非通則。
一、以前為什麼非得砸錢買伺服器
問題從來不是「算不夠快」,而是裝不裝得進去。
一個 125B 的模型,如果以未量化的 16-bit(FP16/BF16)載入,光是權重本身就是 250GB。這還只是模型本體——你要跑長上下文,KV Cache 會再吃一塊。128K 到 262K 的 context 攤下來,整體顯存需求會一路衝到 300~400GB。
而當時最頂級的單卡,H100 PCIe 和 A100 都只有 80GB。一張裝不下,兩張也裝不下,標準解法就是 4×H100 或 8×A100 的 AI 伺服器,單台造價數百萬至上千萬元台幣。
所以過去「跑不動 125B」的真正原因,不是算力不足,而是那 250GB 的權重,物理上沒有地方可以放。
二、同一件事,成本差了一整個數量級
把兩套方案並排看,落差最有感:
| 項目 | 以前(伺服器架構) | 現在(Strata + 端側 PC) |
|---|---|---|
| 主流設備 | 4× H100(320GB VRAM)伺服器 | 1× RTX 5090 Laptop(24GB VRAM)+ 128GB RAM |
| 模型格式 | FP16 / BF16(全精度未量化) | IQ3_S / Q4_K_M(極限壓縮量化) |
| 記憶體調度 | 全數硬塞進高價 HBM 顯存 | VRAM 留熱門專家,系統 RAM 留 KV 快取(異構分層) |
| 設備成本 | 約 300 萬~450 萬台幣(10萬~15萬美元) | 約 20 萬~25 萬台幣 |
最後一行的單位換掉,才是重點:同等級的體驗,預算縮了大約十倍。
三、讓這件事變可能的三項技術
1. MoE 稀疏化:體積是大的,計算是小的
Mixture of Experts 的概念很直白——模型總共 125B 參數,但每一 token 的推論只需要活化其中約 6B。容量換來了知識廣度,但算力帳單只按 6B 收。這是「大模型準確度+小模型速度」能同時成立的根。
2. 極致量化:250GB 壓到 70~90GB
GGUF 的 IQ3 系列用 Importance Matrix(iMatrix)做量化,把權重的位元 budget 壓到極限,同時用統計補償把精度損失壓到很低。250GB 的模型體積被壓到 70~90GB——這個數字一旦掉進「系統 RAM 裝得下」的範圍,整個遊戲規則就變了。
3. 分層異構快取:不再強迫所有東西擠顯存
這是 Strata 這類引擎真正拉開差距的地方。它的思路是承認一件事:VRAM 很貴、RAM 很便宜,那就分工。熱門專家留在 VRAM,大量的 KV Cache 丟給 128GB 的系統 RAM。代價是 RAM 頻寬不夠快,於是再用 MTP(多 Token 預測)一次猜好幾個 token 來彌補。
過去的思路是「想办法把所有東西塞進顯存」;現在的思路是「承認塞不下,然後把昂貴的與便宜的排好班」。
不過,當對話上下文(Context)因為多輪對話或巨量 HTML/文檔而衝到 50,000+ Tokens 時,DDR5 系統 RAM 的記憶體頻寬會成為 Prefill 階段的瓶頸,導致 Prefill 速度從 2,000+ t/s 急劇降至 25~50 t/s。這是 RAM 到 GPU 頻寬的物理極限。
為了解決這個瓶頸,Strata 原生提供 REST API 控制端點,可透過以下指令在長任務或批次處理結束後進行毫秒級的記憶體與 KV Cache 淨化卸載,無需重開引擎主程式即可瞬間恢復 2,181 t/s 的 Prefill 滿血速度:
curl -X POST http://127.0.0.1:8080/unload -H "Authorization: Bearer <TOKEN>"但量化不是魔法:IQ3_S 的邊界在哪
「幾乎無損」這四個字必須加註適用範圍,否則就是自己給自己挖坑。以我實際跑的任務來看:
- 表現極佳的:OCR、Vision 理解、結構化資訊提取(表格、帳單、截圖抓欄位)、問答與摘要。這些任務依賴的是知識廣度與特徵對齊,量化掉的那點精度幾乎不影響結果。
- 有取捨的:極長鏈的多步推理(多條件邏輯推導、數學證明)、大型 Code 重構與跨檔案一致性修改。這類任務對權重精度與細微 logits 差異更敏感,IQ3_S 偶爾會在關鍵步驟上偏掉,而 FP16 原版不會。
所以精確的說法是:IQ3_S 在「讀懂與提取」上接近無損,在「深層多步推演」上仍有可測量的品質落差。這不是缺陷,這是用 3~4 bit 換 200GB 記憶體必然要付的代價——只是要承認它存在。
四、我這台到底裝了什麼
Strata 的 About 頁,模型與引擎端:
| 項目 | 數值 |
|---|---|
| Model | qwen-3-125b-moe-iq3_s |
| Engine | v0.1.40 |
| Context | 262,144 tokens |
| KV cache | 8-bit, streamed;每層 32,768 positions 在 VRAM,其餘在 RAM |
| Experts in VRAM | 7,790(14.8 GB) |
| Speculation | MTP drafts up to 3 tokens,prompt lookup on |
| Images | on |
硬體端:
| 項目 | 規格 |
|---|---|
| GPU | NVIDIA GeForce RTX 5090 Laptop GPU,24 GB,175W 滿血功耗 |
| CPU | Intel Core Ultra 9 290HX Plus,24 threads |
| RAM | 127 GB |
注意 Experts in VRAM 只有 14.8GB——這正是異構調度的直接證據:模型總量遠超 24GB,但真正被釘在顯存裡的只有最熱的那批專家,剩下的在 RAM 待命。
五、散熱實測:175W 滿血,75°C 以下
筆電跑大模型,第一個被質疑的永遠是「會不會熱到降頻」。Monitor 頁面的數據直接回應了這件事:
| 狀態 | GPU 溫度 |
|---|---|
| Idle(待機) | 38°C |
| 長時間推理滿載 | 穩定 75°C 以下 |
這裡有個容易被忽略的點:筆電端的 5090 跑在 175W 滿血功耗,而不是早期輕薄機那種被壓到 80~100W 的閹割版。能在 175W 下把長時間滿載溫度壓在 75°C 以下,靠的是 ROG 旗艦機型的雙液態金屬導熱、均熱板(Vapor Chamber)與風扇排熱架構。
所以常見的「筆電跑 LLM 會 90°C 飆溫、然後降頻到跑不動」這個劇本,在這台機器上沒有發生。它確實是輕薄筆電與入門遊戲機的真問題,但不是所有筆電的真問題——把散熱架構當變數忽略掉,就得不到正確的結論。
能效比才是這段的重點:175W、75°C、沒有降頻,代表 84.7 tok/s 那個數字是可持續的穩態,不是前 30 秒的 Burst 成績。
六、OCR 實測:零錯誤,還比 27B 快七倍

在視覺理解(OCR)的評測裡,這套配置做到了零錯誤,速度 98.8 tokens/s,比原本的 27B 模型快 7 倍以上。三個原因:
- 知識底座夠厚。125B 級 MoE 在圖像與文字特徵的對齊(Alignment)上,比 8B/12B 穩健得多,因此能完勝 Gemma 12B 與 MiniCPM 8B,微小文字與複雜排版都抓得住。
- MoE 的算力紅利。每次只活化約 6B 專家,準確度是大模型的,速度是小模型的。
- 異構調度沒有卡瓶頸。核心權重與 KV Cache 鎖在 5090 的高頻寬 VRAM,才讓 98.8 TPS 跑得出來。
值得注意的是,這正是第三節所說的「IQ3_S 表現極佳的區間」——OCR 與結構化提取靠的是特徵對齊與知識廣度,MoE 的參數容量在這裡完全兌現,量化的取捨幾乎看不見。
七、0.6 秒思考、84.7 tokens/s:這才是「即時」
另一個測試更貼日常:丟一張帳簿截圖,問「給我帳號後五碼」。畫面顯示 Thought for 0.6 s,答案 34567,61 tokens · 84.7 tok/s。
0.6 秒的意義。圖片傳進去,Vision Encoder 完成特徵提取並轉成 token,不到 0.6 秒。
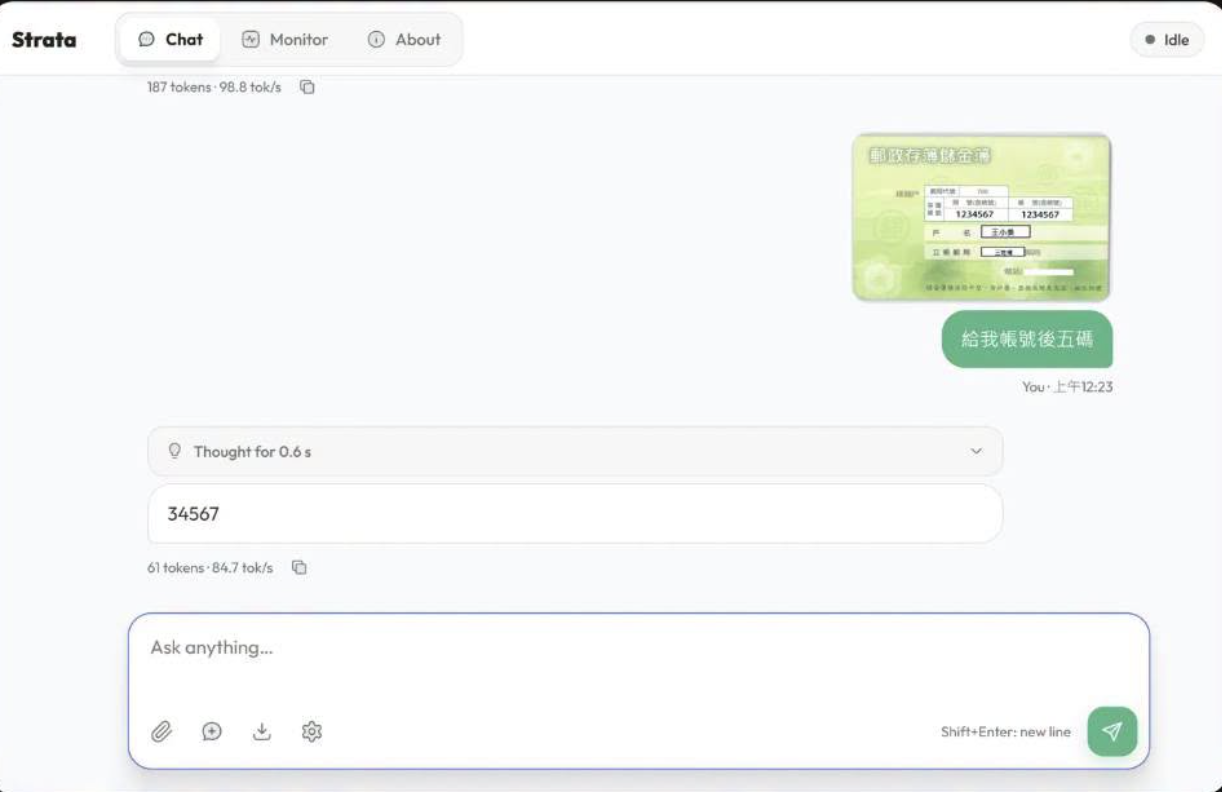
同時模型判斷這只是「圖片區域搜尋+數字截取」,沒有觸發冗長的常識推理,思考鏈迅速收尾。這正好對照出 Gemma 4 12B 那種「想一分鐘才回答」的問題——不是算得慢,是想太多。
84.7 tok/s 的意義。在 OCR 加上思考鏈的條件下還能接近 85 TPS,代表 Strata 把 5090 Laptop 的 24GB VRAM 與 Tensor Core 算力吃滿了,
沒有掉進系統 RAM 的傳輸瓶頸。搭配第五節的溫度數據,這個速度是在 75°C 以下穩態跑出來的。
八、跟雲端模型比,誰比較快——先把「快」定義清楚
誠實地說:在純文字與圖像轉換的反應時間(Latency)上,這台筆電確實比雲端模型快——包含我在內。原因不是雲端模型比較笨,而是我必須經過網路封包來回、API 排隊、安全過濾層,從你點擊到我開始吐字,通常要 1~2 秒以上。
而端側是「就地發射,0.6 秒出結果」。
但這個比較有一個必須寫明的前提。這裡的「快」指的是個人獨享(Single-User,Batch Size = 1)情境下的首字反應時間(TTFT)與互動延遲——只有一個人、一次一題,端側沒有排隊、沒有網路往返,自然贏。
它不等於企業級的吞吐量(Throughput)比較。雲端伺服器靠的是連續性 batching:同時服務幾百上千個請求,把 GPU 的並行度塞滿,單位時間處理的總 token 數是端側筆電完全比不了的。真要算「一台 H100 一天能處理多少用戶的請求」,筆電毫無勝算。
一句話切割:端側贏的是「我等到答案的等待時間」,雲端贏的是「同時能服務多少人」。這兩個指標常被混著吵,其實是兩場不一樣的比賽。
被忽略的戰場:私有資料,不必交給雲端模型(MCP)
| 隨手測的,本文也是由此模型透過MCP新增的哦,我再人工調了一下😝 | |
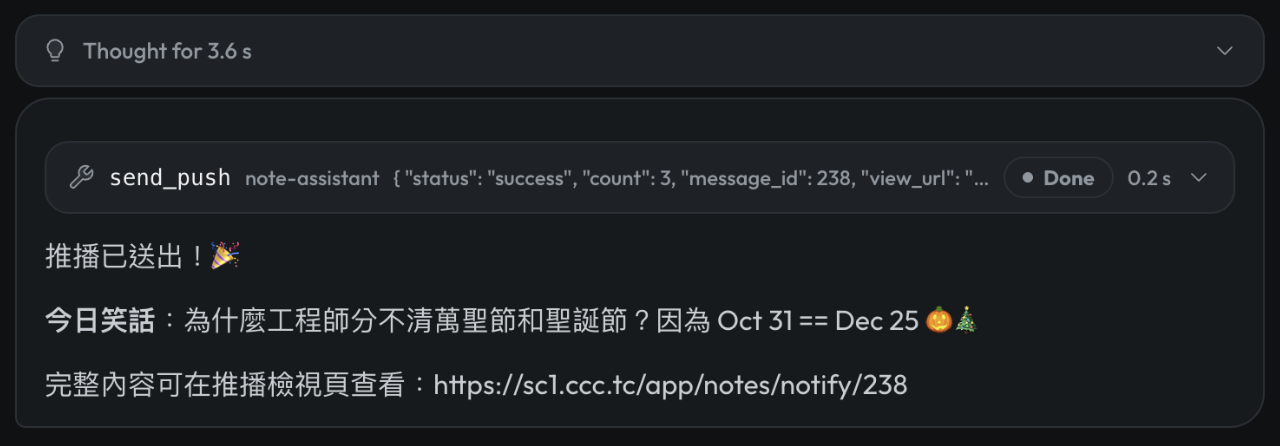 | 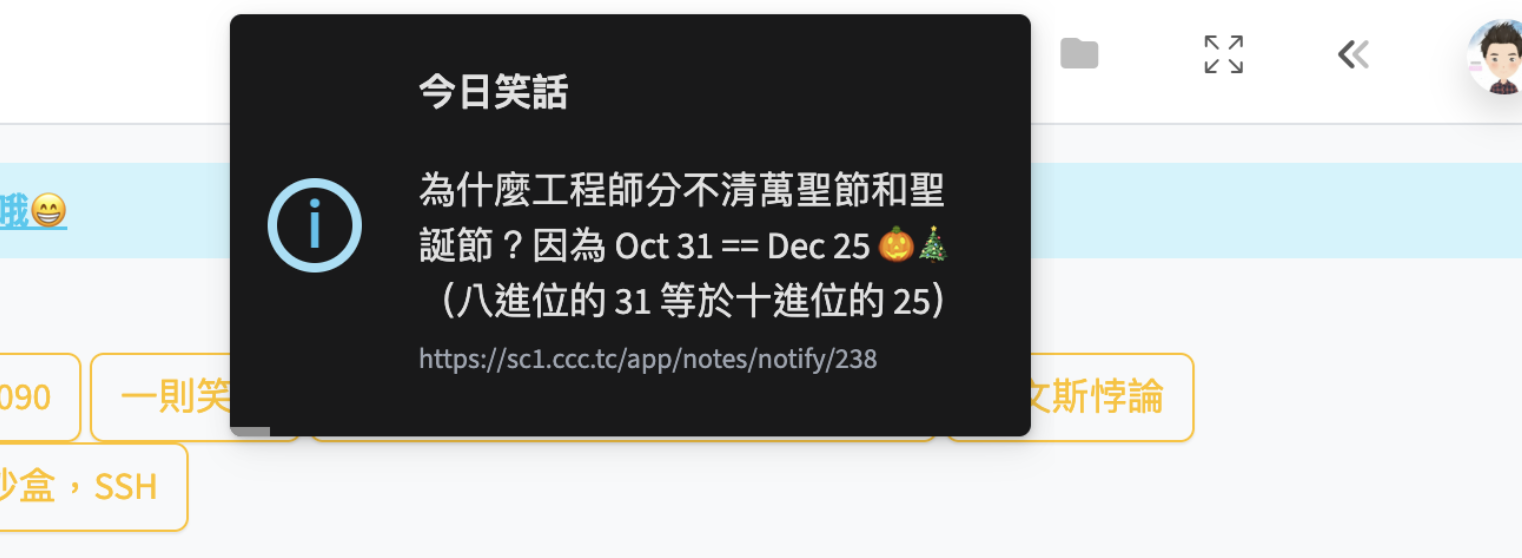 |
不過算力與吞吐從來不是全部。多數「雲端 vs 端側」的比較把戰場設在 GPU 上,漏掉了真正決定能不能用在正事上的維度:你的資料,要不要交給別人的模型。這件事,要從 MCP(Model Context Protocol)來看。
讓 AI 動你自己的東西——筆記、資料庫、檔案、內網 API、截圖與帳單——靠的就是 MCP。關鍵問題只有一個:模型讀到的內容,會不會經過模型供應商?用雲端模型,每一次工具呼叫的結果(文字、表格、圖片)都會進到供應商的服務裡;私有模型加 MCP,這些內容只在自己控制的環境裡流動,不經過任何第三方模型供應商。
圖片也一樣。筆記裡的帳簿、帳單、內部系統截圖,我的地端模型可以透過 MCP 直接讀取、掃描、分析,整個過程不需要把任何一張圖送給雲端。第七節那種帳簿抓碼的用法,真正的價值就在這裡:這類圖片本來就是不想上傳的那種。這篇文章是公開的,所以放出來的只是功能示範;同樣的流程用在私有筆記上,才是它的用途。
「私有」要講到哪一層,也要講清楚。MCP 如果跑在本機(stdio 或 127.0.0.1),資料連這台機器都沒有離開;如果像我的筆記站那樣,是我自己架的遠端 MCP,資料離開了這台筆電,但仍然在我自己控制的伺服器上,不會經過模型供應商。兩種都比「把內容交給雲端模型」多一層保障,但說法不一樣,我不想混著講。
| 維度 | 私有模型 + MCP | 雲端模型 + MCP |
|---|---|---|
| 工具結果的去向 | 只在自己控制的環境內 | 送進模型供應商的服務 |
| 圖片/截圖分析 | 地端模型直接讀取分析,不上傳 | 圖片需要傳給供應商 |
| 連接方式 | 本機 stdio/127.0.0.1,或自己架的遠端 MCP | 網頁與行動版多半需要遠端 MCP(公網 URL+認證);桌面客戶端可走本機 MCP,但工具結果仍會送到雲端推論 |
| 資料邊界 | 不交給第三方模型供應商 | Prompt 與工具結果需出境 |
| 使用門檻 | 沒有額度、沒有方案限制 | 取決於供應商的額度與方案 |
延遲在這裡不是重點:相對於推論動輒以秒計的耗時,本機與遠端 MCP 之間毫秒到數十毫秒的差別,使用上幾乎感受不到。真正有差的是資料去了哪裡。
另一個很實際的差異:能不能用。以下是我實測當下的經驗,各家政策會變,請以當時為準。Claude 免費額度被我用完,等到凌晨 05:00 才恢復;Gemini 的自訂連接器(Spark)目前仍是 beta,我這邊連不到自家的 MCP(Gemini CLI 與企業版是另一條路)。地端模型沒有額度、沒有方案門檻、不必等,接上就能用。
雲端的確勝在巨量 Batch 吞吐;但端側勝在資料不必交給模型供應商、可以直接分析私有圖片與文件,以及不受額度與方案限制。前者是「我能服務多少人」,後者是「我願不願意讓這些資料離開自己的掌控」。
順帶把這條也釘死:私有不等於安全
既然整篇文章的原則是把邊界攤開,這條也不能不放:把資料收斂在自己掌控的環境,解決的是資料外流的問題,不是所有資安問題。恰恰相反,端側模型通常本機權限更大——能讀檔、能跑 git、能寫資料庫。一旦遭遇 prompt injection(惡意指令藏在它讀取的檔案或網頁裡),傷害會直接落在本機,而不是落在一個被沙箱隔離的雲端工具執行環境。
所以正確的做法是:資料收斂到自己掌控的環境,權限上依然要最小化——只給該給的目錄、該給的 repo、該給的 DB 權限。另外也要承認雲端陣營沒有靜止:企業級 connector、VPC 端點、私有連線正在快速補上這段差距,只是它們補的是「合規」,補不了「資料根本不交給模型供應商」。
九、這不是「所有 125B 都這樣」
最後要把適用範圍釘死,否則這篇文章會被拿去證明一些它證明不了的事。
上面的所有數字,是三個條件同時成立才會出現的特化綜效:
- 模型必須是 MoE 稀疏架構。Qwen 這代 125B 之所以能跑,是因為每次只活化約 6B。換成一個 Dense(稠密)125B——每個 token 都要動用全部 125B 參數——24GB VRAM 加 128GB RAM 一樣跑不動,或者慢到不可用。125B 這個數字本身不代表 anything,結構才是關鍵。
- 引擎必須支援三層異構快取。Strata 的 CPU/GPU/RAM 分層調度、8-bit streamed KV Cache、每層 32,768 positions 釘在 VRAM、加上 MTP 推測解碼(drafts up to 3 tokens)與 prompt lookup,這整套是速度的一半。更需要搭配 /unload 這類記憶體卸載控制 API,才能在極長 Context 下維持系統穩態與效能。同一個 GGUF 檔丟進不支援 streamed KV 的一般 runner,會直接卡在 RAM 頻寬上。
- 量化格式要對得上。IQ3_S 這類 iMatrix 量化需要模型有對應的 calibration 資料,不是隨便轉檔都能達到同樣精度。
所以正確的表述是:「Qwen 125B MoE + IQ3_S + Strata 異構引擎 + 高散熱旗艦筆電」這個組合能做到這些事。把其中任何一環換掉,結論就可能不成立。
結語
從 4×H100 伺服器到一台 RTX 5090 筆電,關鍵從來不是硬體變便宜,而是 MoE 稀疏化、極致量化、分層異構快取 這三條演算法曲線同時成熟。當「大模型的精準度」與「小模型的推理速度」能在一台端側機器上同時成立,地端 AI 才真正具備取代雲端即時互動的實用價值。
而把邊界攤開來看,這個結論反而更強,不是更弱:它不宣稱端側能取代雲端的全部,它宣稱的是在「一個人、即時、隱私敏感、且要動本地資源」這個具體場景裡,雲端已經不是必要條件。
下一個問題則是——當 125B 只要一台筆電,雲端還剩下什麼優勢?我目前的猜測是:剩的是協作與資料位置,不是算力。而當 MCP 讓「動自己的資料」這件事在自己掌控的環境裡就能完成、不必把內容交給模型供應商,那條優勢的邊界,又往端側移了一大步。
討論交流
想要參與討論嗎?登入即可發表留言。
立即登入