圖形整合運用
普通的真人 vs 姿態圖 有差嗎?
內容
一句畫有差,而且差距非常大。
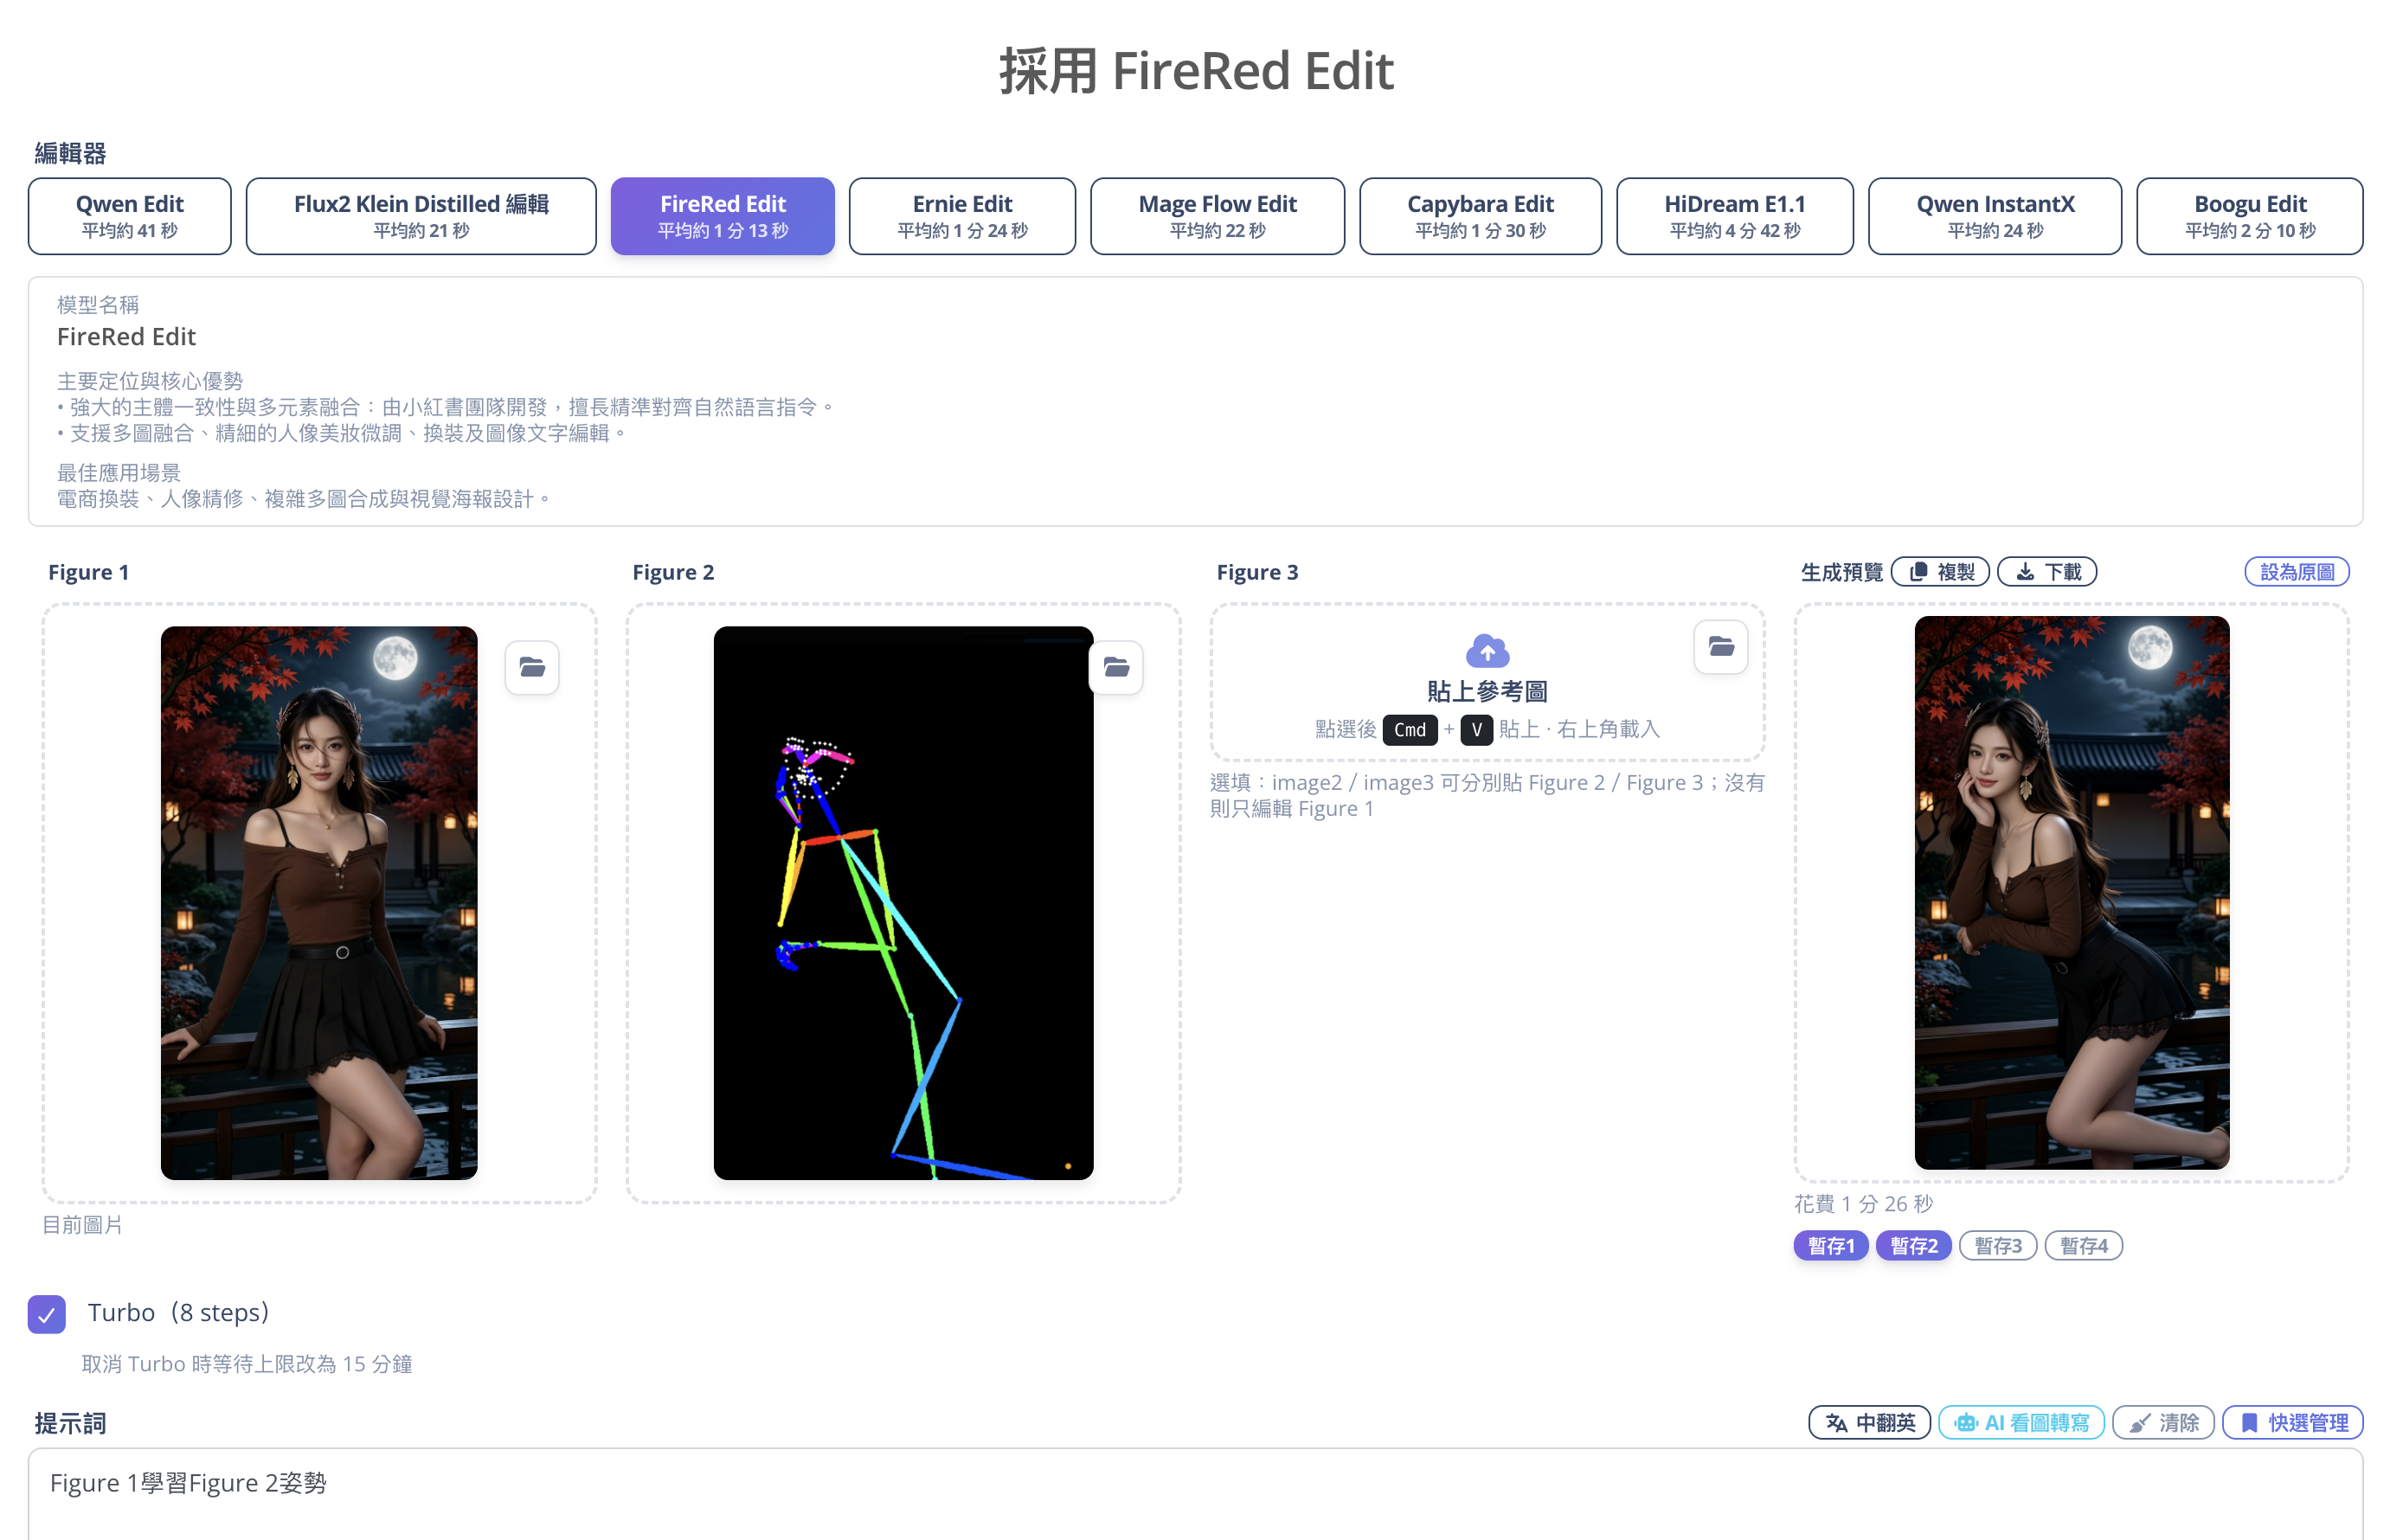
如果只放一張「普通的真人參考圖」讓 AI 學動作,與使用「姿態圖(節點圖)」相比,兩者的底層邏輯和控制精度完全不同:
1. 資訊干擾:AI 會分不清要學「動作」還是學「外觀」
- 不用姿態圖(只用普通人物圖): 原圖包含太多的視覺資訊(臉型、衣服樣式、顏色、光影、背景)。模型在理解「學動作」時,非常容易把原圖的衣服顏色、體型特徵甚至背景風格一起混進去,導致新圖既不像 Figure 1 的角色,動作也不夠純粹。
- 使用姿態圖(節點圖): 畫面上只有純粹的幾何骨架點與連接線,完全沒有任何色彩、布料或皮膚紋理干擾。AI 被嚴格限制「只接收人體運動軌跡」,不會誤吸入其他雜質特徵。
2. 控制精度:微調角度與空間透視(尤其是極端動作)
- 單靠普通圖或提示詞: AI 的理解是概括性的。例如你說「空中跳躍」,AI 可能生成雙腳直立跳、側身跳或隨機屈膝;就算給了參考圖,AI 也很容易「猜錯」關節彎曲角度,產生雙腿長度比例失調、關節逆向反折或手肘穿模。
- 使用姿態圖: 從你的截圖可以看到,姿態圖精確標定了左膝彎曲的銳角、右腿後蹬的幅度、雙手張開的傾斜度與視角仰角。AI 的空間坐標會直接錨定在節點上,能做到 1:1 精準復刻骨架空間關係。
3. 可編輯性(這是姿態圖不可替代的核心)
- 普通參考圖:你只能被動接受原照片裡的姿勢,如果想要手抬高 5 度或頭轉向另一邊,你必須重新找一張剛好符合的照片。
- 姿態圖:節點是可以在畫布或 3D 骨架編輯器中隨意拖曳調整的。你可以自由把骨架的手拉高、把腳踢得更開,AI 就會即時根據你改動後的骨架重新繪製,而不需要重新去找真人素材。
差異對比
| 比較項目 | 只給真人原圖(圖生圖 / 參考) | 使用姿態圖(Pose 節點圖) |
|---|---|---|
| 角色特徵純淨度 | 容易被參考圖的衣服、光影、體型污染 | 零干擾,100% 保持 Figure 1 的角色樣貌 |
| 動作還原度 | 相似、概念符合,但關節細節容易變形 | 像素級/關節級精準對齊 |
| 極端動作穩定度 | 跳躍、俯衝、舞蹈等動作極易產生多手多腳 | 強制約束節點,大幅降低肢體崩壞率 |
| 靈活性 | 無法微調動作,只能靠運氣抽卡 | 可自由拉動點位修改動作細節 |
如果只是「站著看鏡頭」這種日常姿勢,不用姿態圖也能靠提示詞生成;但只要遇到像你畫面中這種空中跳躍、大跨步、特殊透視仰角的動態動作,姿態圖就是保證肢體不崩壞、動作不走樣的唯一硬性約束工具。
Dodoro© (line)
討論交流
想要參與討論嗎?登入即可發表留言。
立即登入
尚無留言,快來留下第一則吧!